返回项目列表

Agent Eval Studio|面向发布决策的 Agent 评测工作台

把 Golden Set、A/B 对比、Bad Case 与发布门禁组织成可运行评测闭环
个人项目|产品设计、评测体系与 AI Coding 2026.08 – 至今 个人独立项目 可运行评测 Demo · 真实模型接入中 2026-08-19
TypeScript Node.js HTML JSON OpenAI-compatible
Agent Eval AI 产品 评测 开源
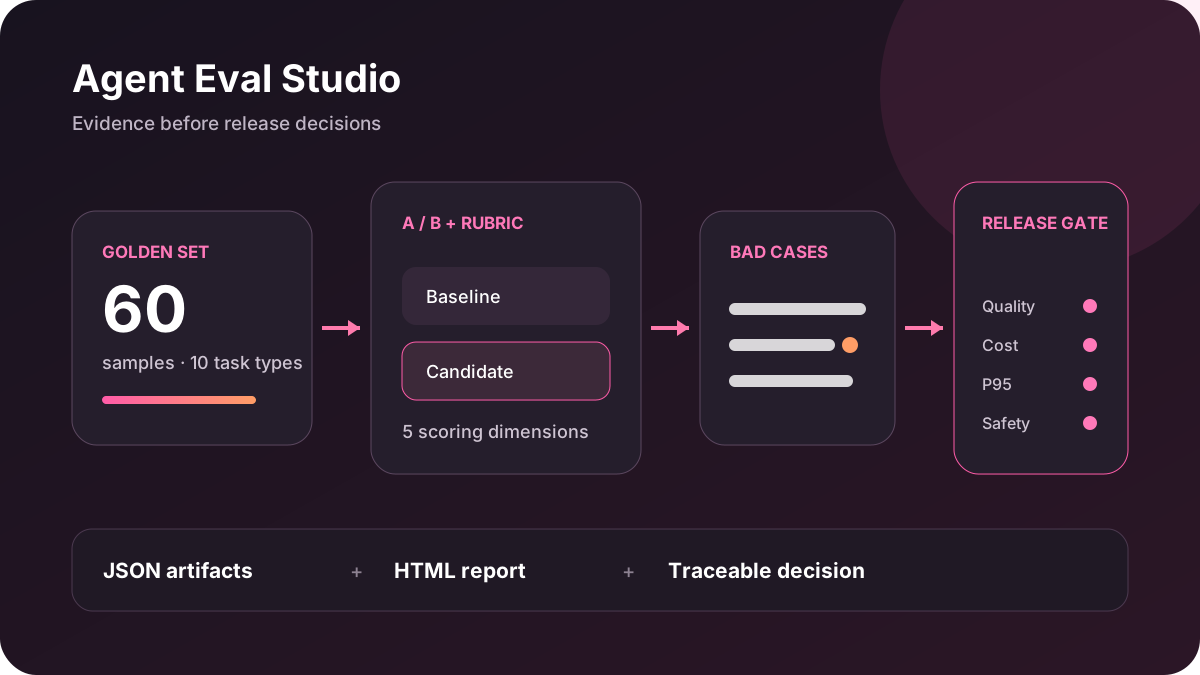
Agent Eval Studio 从 Golden Set 到发布门禁的评测流程
01

30 秒摘要

我把“感觉这个 Agent 更好”改造成可复核的发布判断:固定样本与评分口径,对比基线和候选版本,聚合 Bad Case,并用多目标门禁决定是否放行。

02

3 个关键数字

60
Golden Set 样本仓库内可审查数据集
10
任务类型覆盖不同能力与风险场景
5
评分维度统一 Rubric 支持 A/B 比较
03

产品流程

  1. 01
    定义 Golden Set

    固定任务、期望与风险标签。

  2. 02
    运行 A/B

    在同一批样本上执行基线与候选方案。

  3. 03
    按 Rubric 评分

    将多个质量维度转成结构化结果。

  4. 04
    聚合 Bad Case

    按类型定位退化和失败模式。

  5. 05
    检查多目标门禁

    联合判断质量、成本、P95 与安全。

  6. 06
    归档报告

    输出 JSON 工件与可读 HTML 报告。

04

两个关键决策

01

默认提供确定性 Mock,而不是强制调用真实模型

为什么这样选
评测框架本身需要可复现、可测试,也应允许没有 API Key 的审阅者运行完整流程。
没有选择
把真实模型 API 设为唯一运行路径
取舍
当前结果不能代表线上模型效果,但评测逻辑和报告链路可以稳定复核;真实模型适配仍在接入。
02

用多目标发布门禁,而不是只比较平均质量分

为什么这样选
平均分可能掩盖安全退化、尾延迟和成本上升,这些都可能阻止真实发布。
没有选择
候选版本平均质量更高就自动放行
取舍
判断更严格、参数更多,但发布结论更接近真实产品约束。
05

一个 Bad Case

平均分提升,却隐藏了高风险退化

现象
候选版本在多数普通样本上得分更高,但少量安全任务失败,平均值仍显示正向。
诊断
单一聚合指标把关键失败稀释在大量普通样本里。
处理
把风险标签、Bad Case 分组和安全门禁设为独立阻断条件。
结果
报告不再只回答谁的均分更高,也说明为什么当前版本不能发布。
06

结果与验证状态

评测流程已验证 · 真实模型效果待验证

仓库包含可运行命令、自动化测试、60 条样本、JSON 工件和 HTML 报告。当前 provider 为确定性 Mock,OpenAI-compatible 配置尚未执行真实模型请求。

07

证据链接

08

完整复盘

项目概述

Agent Eval Studio 是一个面向版本比较与发布决策的开源评测工作台。它把评测数据、评分规则、运行结果和发布条件组织成一条可追溯链路,重点不是展示一个漂亮分数,而是让团队能解释候选方案为什么能或不能发布。

痛点机会

Agent 团队容易依赖挑选过的 Demo、主观体验或平均分。这样既无法复现判断,也可能让少量高风险失败被整体均值掩盖;同时,质量提升如果伴随成本或尾延迟恶化,也不一定适合上线。

目标指标

目标是建立可重复的 A/B 评测基线:相同数据、相同 Rubric、结构化 Bad Case 和明确门禁;审阅者无需 API Key 也能运行流程,同时对真实模型尚未接入这一边界保持透明。

用户调研

方案围绕 Agent 评测的核心证据链展开:Golden Set 保证输入稳定,分维度 Rubric 避免单分数失真,Bad Case 解释失败模式,多目标门禁把评测结论连接到发布约束。

方案设计

数据层记录任务、期望和风险标签;运行层让基线与候选版本接受同一输入;评分层输出五个维度;分析层聚合任务类型和 Bad Case;门禁层共同检查质量、成本、P95 延迟与安全;报告层同时生成机器可读 JSON 和人可读 HTML。

落地推进

我使用 TypeScript 与 Node.js 完成 CLI、确定性 provider、数据读取、评分聚合、门禁和报告生成,并为关键逻辑补充自动化测试。OpenAI-compatible 配置作为扩展入口保留,但当前实现明确不把 Mock 结果包装成真实模型效果。

效果复盘

当前版本可以端到端运行 60 条样本,比较两个确定性方案,输出维度分数、Bad Case、发布判断、JSON 工件与 HTML 报告。它验证了评测产品和工程链路,但没有证明任何真实模型或 Prompt 的效果提升。

迭代反思

评测工具最重要的产品价值不是自动给分,而是让决策证据可复核。下一步应先接入真实 provider 与人工校准样本,再比较自动评分和人工判断的一致性;在此之前,清楚标记验证边界比制造一个看似完整的线上指标更重要。